Naast mijn monitor staat een Mac Mini M4 met 24 GB geheugen. Ik hoor hem niet. Er draaien AI-modellen op die mijn data nooit naar buiten sturen.
Voor AI lokaal draaien is een Mac een sterke keuze, door één technisch detail: unified memory. Maar niet alles past. Hieronder staat wat er op mijn Mac Mini werkt, wat niet, wat het aan stroom kost en welke Mac je nodig hebt.
Waarom een Mac voor AI lokaal draaien
Een AI-model moet helemaal in het geheugen passen waar de rekenchip bij kan.
Bij een gewone PC is dat het geheugen van de videokaart. Heeft je videokaart 12 GB, dan past er een model van hooguit 12 GB, ook als je PC zelf 32 GB werkgeheugen heeft.
Bij een Mac met Apple Silicon zitten de processor en de grafische chip op één chip, met één gedeelde geheugenpool. Dat heet unified memory. Van mijn 24 GB kan het model het grootste deel gebruiken. Een deel blijft nodig voor macOS en je andere programma's.
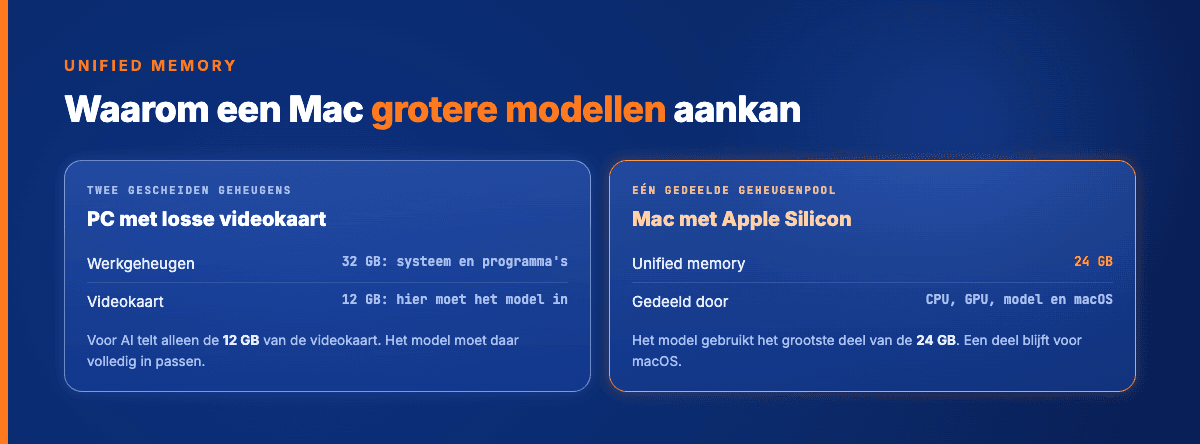
Een PC met een snelle videokaart is wel sneller voor kleine modellen die in dat videogeheugen passen. Wie al een gamekaart heeft, hoeft niets te kopen. De Mac wint zodra je modellen wilt draaien die groter zijn dan een betaalbare videokaart aankan. Hij wint ook wanneer stil en zuinig zwaarder weegt dan de snelste antwoordtijd.
Wat er op mijn Mac Mini draait
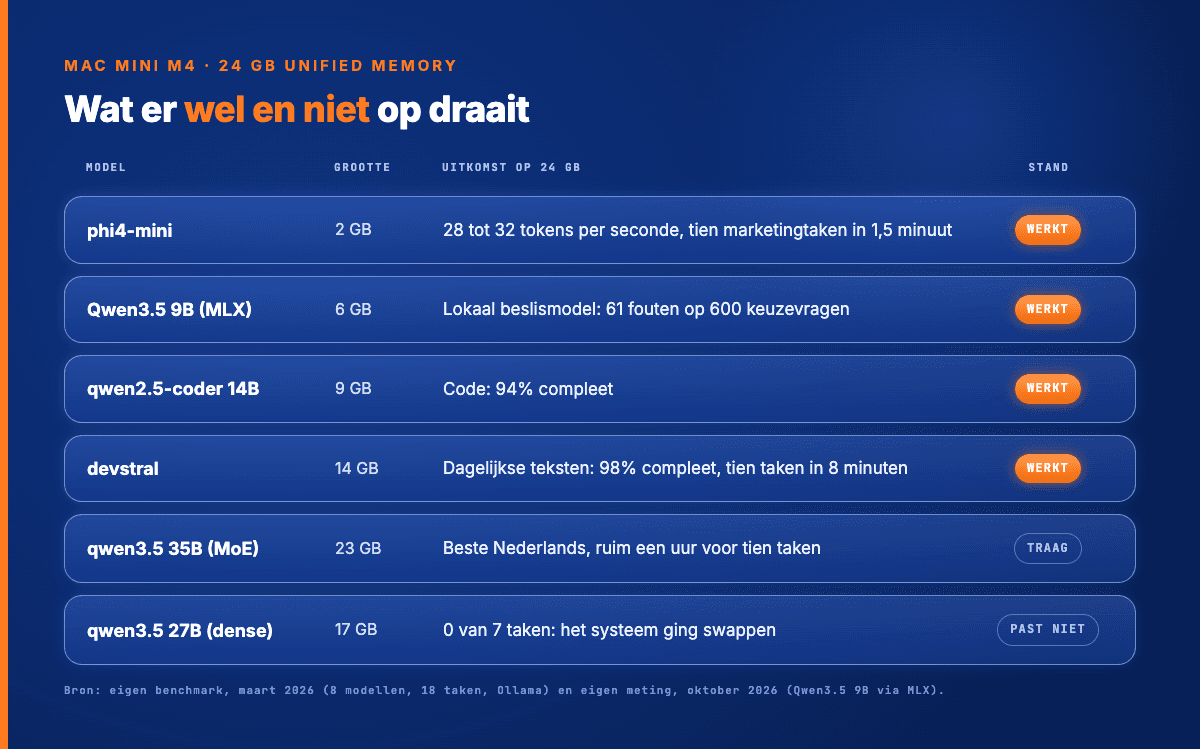
In maart testte ik 8 modellen op 18 echte taken, van code tot Nederlandse marketingteksten. In oktober testte ik een klein model als lokaal beslismodel. Dit is de stand op 24 GB.
| Model | Grootte | Uitkomst op 24 GB |
|---|---|---|
| phi4-mini | 2 GB | Werkt en is snel: 28 tot 32 tokens per seconde, tien marketingtaken in anderhalve minuut |
| Qwen3.5 9B (via MLX) | 6 GB | Werkt als lokaal beslismodel: 61 fouten op 600 keuzevragen |
| qwen2.5-coder 14B | 9 GB | Werkt voor code: 94% compleet |
| devstral | 14 GB | Werkt voor dagelijkse teksten: 98% compleet, tien taken in ongeveer acht minuten |
| qwen3.5 35B (MoE) | 23 GB | Past, maar traag: beste Nederlands, ruim een uur voor tien taken |
| qwen3.5 27B (dense) | 17 GB | Past niet: 0 van 7 taken, het systeem ging swappen |
Dat 35B wel draait en 27B niet, lijkt onlogisch. Het 35B-model is een mixture-of-experts: het gebruikt per woord maar een klein deel van zichzelf. Het 27B-model rekent met alles tegelijk en heeft samen met zijn context meer geheugen nodig dan er vrij is.
In een eerdere versie van dit artikel schreef ik dat ik 's nachts het 27B-model liet draaien. Dat klopt niet. Mijn eigen benchmark laat zien dat het op 24 GB niet werkt.
De volledige cijfers en de instellingen staan in mijn lokale LLM-benchmark op de Mac Mini M4. De oktobermeting met het beslismodel staat in AI lokaal draaien als beslismodel.
Wat ik niet lokaal doe
Lokaal is sterk voor tekst, samenvattingen, classificatie en eerste drafts, zeker als de data het kantoor niet uit mag.
Zware, foutgevoelige code laat ik niet lokaal schrijven. Op de hardste codeertaken liep een 9B-model op twee van de acht vast. Daar gebruik ik een cloud-model, met controle achteraf.
Wat het aan stroom kost
Apple geeft voor de Mac Mini M4 zelf 4 watt op in rust en maximaal 65 watt (Apple Support). Ik heb het niet zelf gemeten.
Een bovengrens kun je zelf uitrekenen. Draait hij 24 uur per dag op het maximum, dan is dat 65 watt maal 24 uur: 1,56 kWh per dag. Bij €0,30 per kWh is dat ongeveer €14 per maand.
In de praktijk ligt het lager. Hij staat het grootste deel van de dag in rust. Een PC met een zware videokaart vraagt onder belasting een veelvoud daarvan.
Welke Mac heb je nodig?
Kies op geheugen, niet op chip.
- 8 tot 16 GB: kleine modellen zoals phi4-mini. Genoeg voor samenvattingen, vertalingen en snelle drafts.
- 24 GB: wat ik heb. Modellen tot ongeveer 14 GB werken comfortabel, een 35B MoE-model past maar is traag.
- 48 GB of meer: grotere dense-modellen, of meerdere modellen tegelijk.
- Mac Studio: sinds augustus 2026 met M5 Max of M5 Ultra, tot 512 GB geheugen. Voor teams en ontwikkelaars, voor de meeste MKB-toepassingen te veel.
Mijn metingen gaan over de M4. Sinds september 2026 verkoopt Apple een nieuwe Mac Mini met M6 en M5 Pro. De regel blijft hetzelfde: het geheugen bepaalt welk model past.
📖 Lees ook: Welke AI-modellen kun je lokaal draaien?: per model wat het kan en hoeveel geheugen het vraagt
Zo begin je
- Download Ollama via ollama.com. Het is gratis en beheert de modellen voor je.
- Open de Terminal en typ:
ollama pull qwen3.5:9b - Stel je eerste vraag:
ollama run qwen3.5:9b "Vat deze tekst samen in 3 punten"
Geen account, geen API-sleutel en geen maandelijkse kosten. Meer over dit model staat in Qwen3.5 lokaal draaien.
Veelgestelde vragen
Waar je nu staat
Lokale AI draait om controle. Je data blijft binnen, je bent niet afhankelijk van één leverancier en je betaalt niet per gebruiker. De Mac maakt het praktisch, zolang je weet wat erop past.
Wil je weten welke opzet bij jouw bedrijf past? Lees hoe ik AI-architectuur voor het MKB ontwerp.