Onder mijn post over Jev kreeg ik een reactie die raak was. Jev is gebouwd om grote aantallen beslissingen snel en goedkoop te nemen. Wat kost nabouwen bij miljoenen beslissingen in plaats van 450?
Mijn eerste gedachte: dat kan ook lokaal. Dan is elke beslissing gratis. Alleen had ik dat nog niet gemeten.
Dus liet ik AI lokaal draaien op de Mac mini op mijn bureau. Dezelfde 450 teksten, dezelfde vragen en dezelfde Python-code als in mijn test van Jev.
De uitkomst: gratis per beslissing klopt. Een miljoen beslissingen kost mijn Mac alleen ruim 18 dagen rekenen.
Hoe ik het beslismodel lokaal draaide
Een beslismodel schrijft geen tekst. Je geeft het een tekst en een vraag met vaste antwoorden. Je krijgt een keuze met een kans terug. Jev van TypeSafe doet dat als dienst in de cloud.
Hetzelfde trucje kan op elk open taalmodel. Hoe goed het werkt, verschilt per model. Je laat het antwoorden met één letter en leest af hoe zeker het was. Dat is wat ik nu op mijn eigen computer deed.
- De machine: een Mac mini met M4 en 24 GB geheugen.
- Het model: Qwen3.5 9B van Alibaba, verkleind tot 6 GB. Daarnaast de kleinere 4B-versie van 3 GB.
- De software: MLX, de software van Apple om AI-modellen op een Mac te draaien.
Grotere modellen passen niet met marge in 24 GB naast de rest van het systeem. Op dezelfde Mac liepen tijdens de meting ook andere werksessies door. De cijfers zijn dus een momentopname.
Ik legde vooraf vast wat ik zou meten en wat ik verwachtte. Pas daarna draaide ik de test. Dat voorkomt dat ik achteraf kies welk getal er mooi uitziet.
Hoe goed een lokaal AI-model beslist
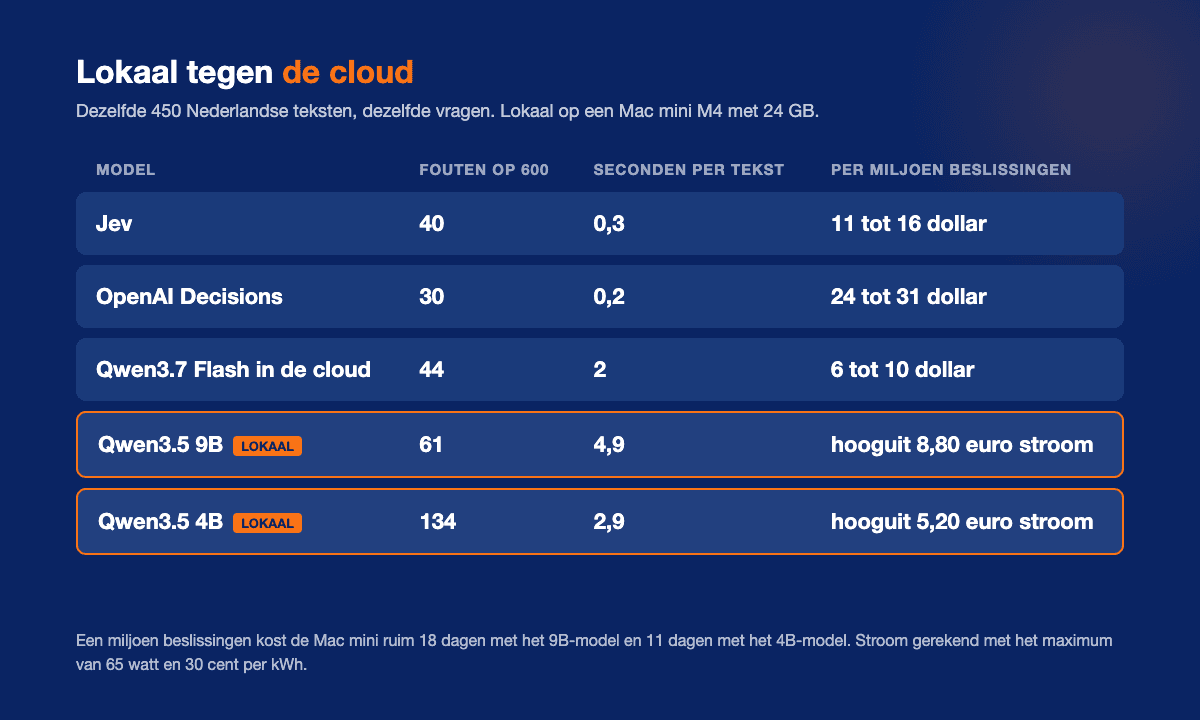
Op 600 keuzevragen maakte het lokale 9B-model 61 fouten. Jev maakte er 40. Qwen3.7 Flash in de cloud, een nieuwere generatie uit dezelfde familie, maakte er 44. De Decisions API van OpenAI maakte er 30.
Het lokale model maakt dus aantoonbaar meer fouten dan elk van de drie. Dat heb ik statistisch getoetst.
Op de moeilijkste teksten kon ik tegen Jev en Qwen3.7 Flash geen verschil aantonen. In een extra toets, die ik niet vooraf had vastgelegd, deed OpenAI Decisions het daar wel beter.
De helft van de fouten, 30 van de 61, zit op één klasse: zoekvragen waarmee iemand een bepaalde pagina zoekt.
Die klasse had ik in mijn eerste test al te vaag gedefinieerd. Daar struikelt elk model over, alleen het kleine iets vaker.
De kansen kloppen wel. Als het model 90 procent zeker is, zit het er ongeveer zo vaak naast als je zou verwachten. Dat is wat je nodig hebt om met een drempel te werken.
Eén ding om op te letten. Bij de vraag of een mens een klachtmail moet oppakken, liet het lokale model er 15 liggen die wel naar een mens hadden gemoeten. Jev miste er geen.
Dat hangt aan de drempel. Achteraf bekeken mist het lokale model bij een drempel van 0,3 er nog 5 en stuurt het er 14 onnodig door. Die drempel kies je zelf, op je eigen voorbeelden.
Het kleinere 4B-model is 1,7 keer zo snel. Het maakte wel 134 fouten, meer dan het dubbele.
Op de moeilijke teksten scoorde het in alle drie de tests aantoonbaar lager dan het 9B-model. Kleiner is hier geen besparing.
Hoe snel: het getal waar het om draait
Het lokale model doet meestal 1,3 seconde over één vraag. Langere teksten duren langer. Met drie of vier vragen per tekst is dat bijna 5 seconden per tekst.
Jev doet dezelfde tekst in ongeveer 0,3 seconde, met alle vragen in één keer.
Na elkaar haalt mijn Mac gemiddeld 2.211 beslissingen per uur. Een miljoen beslissingen duurt dan 452 uur. Dat is ruim 18 dagen zonder pauze.
Ik dacht dat vier vragen tegelijk sturen zou helpen. Het leverde 23 procent minder beslissingen per uur op. Bij de eerste 100 mails was het even snel.
Het verlies zat helemaal in de 50 langere, moeilijke mails.
Het model schrijft maar één letter. Bijna alle tijd gaat naar het inlezen van de vraag en de tekst. Die rekenkracht deelt de Mac gewoon tussen de vier.
Twee derde van wat hij inleest, is de vraag met de definities. Die is voor elke tekst hetzelfde.
Sneller gaat met een zwaardere machine of met meer machines. Het vaste deel van de vraag hergebruiken kan ook schelen. Dat heb ik niet getest.
Wat het kost
Per beslissing kost het lokale model niets. Er gaat geen tekst naar een leverancier en er komt geen rekening.
Wel stroom. Apple geeft voor de Mac mini met M4 een maximaal verbruik van 65 watt op. Bij 452 uur op vol vermogen is dat 29 kWh.
Tegen 30 cent per kWh kost een miljoen beslissingen dan hooguit 9 euro.
Het echte verbruik ligt lager. De Mac draait niet de hele tijd op zijn maximum. Dat heb ik niet gemeten.
Jev kost 11 tot 16 dollar per miljoen beslissingen. De Decisions API van OpenAI 24 tot 31 dollar. Lokaal is goedkoper dan Jev en OpenAI.
Tegen Jev scheelt het per miljoen een paar euro. Qwen3.7 Flash in de cloud kost ongeveer evenveel als mijn stroom. Het grote verschil zit in de tijd.
Dat geeft de reactie onder mijn post voor een deel gelijk. Wie miljoenen beslissingen per dag moet nemen, is met een dienst als Jev sneller klaar.
De prijs is daarbij geen argument meer, de snelheid wel.
Lees ook: Beslismodellen als Jev: welke AI-toepassingen werken: vijf toepassingen die ik mat en waar ik een beslismodel nooit laat beslissen
Wanneer lokaal de betere keuze is
Lokaal wint op drie punten.
De tekst verlaat je computer niet. Klachtmails bevatten namen, adressen en soms gezondheidsinformatie. Lokaal komt er voor de beslisstap geen extra verwerker bij, ook niet in de Verenigde Staten.
Je hangt niet af van één leverancier. Geen prijs die volgend jaar verandert, geen sleutel die verloopt en geen dienst die stopt.
Je volume heeft geen haast. Mijn Mac haalt ruim 50.000 beslissingen per etmaal. In een nacht van tien uur sorteert hij ruim 5.000 klachtmails met drie vragen elk.
Een webshop met 500 mails per dag heeft er minder dan een uur voor nodig.
Een volgende stap is het model trainen op je eigen vragen en categorieën. Dat heb ik nog niet gemeten.
Mijn eerste test leert wel waar je dan begint: met scherpe definities. Een model leert ook je vage klassen.
Wanneer een dienst als Jev wint
- Je moet direct antwoord hebben. Een klant die wacht, wacht geen 5 seconden per bericht.
- Je volume is groot. Miljoenen per dag vraagt om rekenkracht die een kantoor-Mac niet heeft.
- Je wilt scores. Bij twee van de drie scorevragen was Jev nauwkeuriger dan mijn lokale model. Bij koopbereidheid scoorden ze even goed.
In maart testte ik hetzelfde 9B-model als schrijfhulp op deze Mac, in mijn benchmark van lokale modellen op een Mac mini. Het deed ruim een uur over tien marketingteksten.
Als beslismodel, met één letter als antwoord, doet het een tekst in 5 seconden. De taak bepaalt welk model past.
Veelgestelde vragen
Waar je begint
Twijfel je of een beslismodel bij jou lokaal kan of beter als dienst draait? Dat hangt af van je volume, je snelheid en je gegevens. Hoe ik dat met je uitzoek, lees je op mijn pagina als AI-consultant.