Ik liet AI-modellen 150 klachtmails beoordelen. Eén vraag was: moet een mens dit oppakken? Twee modellen hadden er allebei 84 procent goed.
Het ene stuurde 24 mails onnodig naar een medewerker. Het andere liet 23 mails liggen die wel een mens nodig hadden. Hetzelfde percentage, een ander risico.
Daar begint voor mij elke toepassing van een beslismodel. Bij de vraag welke fout je je kunt veroorloven.
Wat een beslismodel wel en niet doet
Een beslismodel schrijft geen tekst. Je stelt een gesloten vraag, zoals "welke afdeling" of "ja of nee". Je krijgt een antwoord met een kans erbij.
Jev van TypeSafe AI kwam half september uit. OpenAI volgde op 29 september met de Decisions API.
Het eerste model uit de opening was die API van OpenAI.
Het tweede was geen beslismodel. Dat was Claude Haiku 5.5, een gewoon taalmodel, met het denkwerk uitgezet. Dat verschil in fouten zie je verderop terug.
Wat je niet krijgt, is een reden. Een beslismodel zegt 0,91 en verder niets. Geen zin uit de bron, geen uitleg.
Het is wel goedkoop en snel. Duizend beslissingen kostten in mijn test 1 tot 2 cent bij Jev en 2 tot 3 cent bij OpenAI. Een antwoord kwam in ongeveer 0,2 tot 0,3 seconde terug.
Vijf AI-toepassingen die ik zelf heb gemeten
Ik test zulke modellen op mijn eigen werk en op teksten waarvan ik het juiste antwoord vooraf vastleg. Dit zijn de vijf plekken waar ik het gemeten heb.
1. Mail en tickets verdelen
De klachtmails uit de opening horen bij een webshop die niet bestaat. Een AI-model schreef ze, nadat ik per mail het juiste antwoord had vastgelegd.
Dat model komt uit dezelfde familie als Haiku, wat Haiku iets kan bevoordelen.
Per mail stelde ik drie vragen in één keer: waar gaat het over, hoe dringend is het en moet een mens het oppakken. Dat doet een klantenservice nu vaak met de hand.
Op de mens-vraag misten beide beslismodellen geen enkele mail die een mens nodig had. Ze vergisten zich alleen naar de veilige kant. Jev stuurde er 11 te veel door, OpenAI 24.
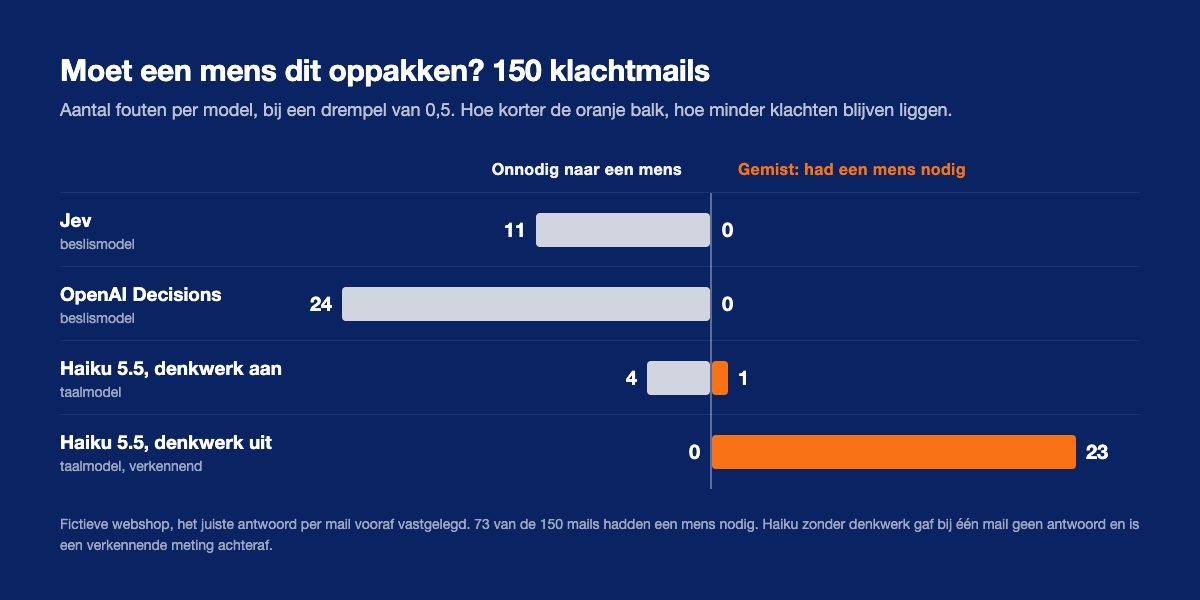
Haiku zonder denkwerk deed het omgekeerde. Het stuurde niets te veel door en liet er 23 liggen. Op één mail gaf het geen antwoord. Dat is de fout die een klant merkt.
Met het denkwerk aan deed Haiku het beter dan beide beslismodellen: 4 te veel en 1 gemist. Dat kost wel tijd: ongeveer 3 seconden per mail, tegen 0,2 tot 0,3 seconde.
Bij OpenAI zat het probleem in de drempel. De volgorde van de kansen klopte bijna perfect. Alleen de grens van 0,5 paste er niet bij.
Met een grens van 0,95 was het 97 procent goed: 3 mails te veel en 1 gemist. Die grens koos ik wel achteraf, op dezelfde mails. OpenAI zegt zelf: kies je drempel op je eigen voorbeelden.
2. Meldingen sorteren
Mijn eigen kwaliteitscontrole levert bij elke wijziging bevindingen op. Ik wilde weten welk soort het was: stijl, fout, beveiliging of beleid.
Jev deelde 671 bevindingen in voor 2 cent. Op de groep waarvan ik het antwoord zeker wist, had het 88,5 procent goed. Mijn vaste trefwoordregel haalde 63,9 procent.
Dat is gemeten op één soort, de makkelijkste. Voor de rest had ik geen goed antwoord om tegen te meten.
3. Zoekvragen indelen
Voor een fietsenwinkel die niet bestaat liet ik zoekopdrachten indelen. Wil iemand iets weten, iets kopen of een vestiging vinden?
Negen fouten deelden Jev, OpenAI en Haiku met denkwerk aan. Allemaal bij het label "navigerend", dat ik zelf te vaag had omschreven.
Dat was mijn fout, niet die van de modellen. Een beslismodel is precies zo goed als de vraag die je stelt.
4. Salesgesprekken lezen
In fragmenten van nagemaakte salesgesprekken liet ik vragen of er een beslisser genoemd wordt. Bijvoorbeeld een directeur of compagnon die mee moet beslissen.
Jev had 97 procent goed, OpenAI 99 procent. Een salesteam zet zo'n vinkje nu na een gesprek met de hand in het CRM. Het antwoord is ja of nee, geen verhaal. Daar is dit soort model voor gemaakt.
5. Vinden wat je eigen regels missen
Deze vond ik het nuttigst. Ik heb een vaste controle die schrijftics in mijn teksten vangt. Ik liet Jev zoeken naar zinnen die erop leken en toch door die controle kwamen.
Het vond drie patronen die ik daarna als vaste regel toevoegde. Die regels vangen nu 92 extra gevallen in mijn gepubliceerde teksten. De hele zoektocht kostte minder dan een cent.
Let op wat daar gebeurde. Jev besliste niet wat fout was. Het wees aan welke regel ik moest bouwen. Die regel doet daarna het werk, elke keer op dezelfde manier.
Lees ook: Jev vs OpenAI's Decisions API vs Claude Haiku 5.5: de volledige meting op 450 teksten, in het Engels
Wat leveranciers noemen en ik niet heb gemeten
OpenAI noemt in de eigen handleiding ook een productfoto controleren op zichtbare schade. Boven een drempel die je zelf kiest, markeer je de foto voor controle.
TypeSafe noemt Jev in de aankondiging "smart if-statements": een slimme als-dan-regel in je software. Het noemt ook het controleren van andere AI.
Simon Willison gebruikte het om zoekresultaten opnieuw te rangschikken.
Die heb ik niet getest. TypeSafe noemt in de aankondiging ook geen klanten. Over de eigen snelheids- en kostencijfers schrijft het bedrijf zelf dat die "on the higher end of real world gains" liggen.
Waar ik een beslismodel nooit laat beslissen
Als laatste controle. Het model mag aanwijzen waar ik moet kijken. Het mag niet het oordeel zijn dat een wijziging tegenhoudt of doorlaat.
Een vaste regel faalt elke keer op dezelfde plek. Een model faalt bij bijna volledige zekerheid op een plek die je niet ziet.
Waar een klant een reden nodig heeft. Een score van 0,73 zonder zin uit de bron is voor een klant een slechter product, ook als het getal klopt.
Over mensen, met gevolgen. Sollicitanten rangschikken of kredietwaardigheid inschatten geldt in de AI-verordening als hoog risico.
Door de Digital Omnibus gelden die zware eisen vanaf 2 december 2027. Willison waarschuwt expliciet tegen sollicitanten rangschikken met Jev.
En los daarvan geeft artikel 22 van de AVG mensen het recht niet te worden onderworpen aan een uitsluitend geautomatiseerd besluit dat rechtsgevolgen heeft of hen in aanmerkelijke mate treft.
Het Europese Hof bepaalde in 2023 in de SCHUFA-zaak dat een score zelf dat besluit kan zijn, als iemand er zwaar op leunt.
Een prioriteit voor je klantenservice valt daar doorgaans niet onder. Een filter dat sollicitanten zonder menselijke blik afwijst wel.
Wat dat voor jouw situatie betekent, staat op mijn pagina over de AI Act voor het MKB.
Waar een vaste regel het al doet. Voor een mail met het woord "factuur" heb je geen model nodig. Een regel kost niets en is direct klaar.
Bij mijn eigen systemen stond die gratis laag er in alle vier al vóór het model, zoals ik in de rekensom achter "400 keer goedkoper" liet zien.
Vier vragen voordat je er een inbouwt
- Kun je elk antwoord in één zin omschrijven? Lukt dat niet, dan maakt elk model dezelfde fout. Dat liet het label "navigerend" zien.
- Welke fout is goedkoop? Een mail te veel bij een medewerker kost een minuut. Een gemiste klacht kost een klant. Kies je drempel daarop, op je eigen voorbeelden.
- Wie gebruikt het antwoord? Voor een systeem volstaat een getal. Een mens die het leest, heeft een reden nodig.
- Wat gebeurt er onder de drempel? Leg vast wie de twijfelgevallen krijgt voordat je live gaat. Anders blijven ze liggen.
De laatste vraag wordt het vaakst overgeslagen. Een drempel instellen is één regel code. Het pad voor de gevallen eronder is werk. Dat werk bepaalt of het systeem klopt.
Een beslismodel mag kiezen welk gereedschap er komt. Nooit wat het gereedschap vindt.