Begin oktober vulde ik een privacyvragenlijst in over OnCue, de notetaker die ik zelf bouw. Bij elke vraag legde ik mijn eigen documentatie naast de code.
Op drie plekken beloofde de documentatie meer dan de code deed.
Elke leverancier noemt zijn tool voor notuleren met AI privacy by design. Wat dat betekent, zie je pas als je de belofte naast de werking legt. Bij mijn eigen tool had ik dat nooit gedaan.
In mijn vorige stuk over spraak naar tekst ging het over waar je opname heen gaat.
Dit stuk gaat over de stap erna: wat er met de tekst gebeurt. En over de drie vragen die je elke notetaker stelt voordat je hem aanzet.
Wat ik vond toen ik mijn documentatie naast de code legde
OnCue luistert mee met een gesprek in Teams, Zoom of Meet. Het zet het gesprek op mijn eigen computer om in tekst.
Het was vanaf het eerste idee lokaal, met governance voorop. Een cloudmodel is een optie, geen vertrekpunt. Toch liep de tekst op vier plekken scheef.
- Er ging meer tekst naar buiten dan "korte fragmenten". De documentatie sprak van fragmenten van één tot drie zinnen. Met een taalmodel ingesteld ging er elke minuut een lopende samenvatting naar buiten. In de nieuwe versie gaat na afloop ook het hele transcript mee.
- Het voorbeeldbestand koos een cloud die de README niet noemde. De README noemde lokaal de standaard. Het voorbeeldbestand waarmee je begint, had Google Gemini ingevuld. Zonder eigen sleutel ging er niets naar buiten. Met een sleutel kreeg je Gemini zonder ervoor te kiezen.
- De namenfilter kent ongeveer 190 voornamen. Een naam die niet op die lijst staat, gaat er ongefilterd doorheen. Ik heb het getest met de echte filter. Verderop staat wat eruit kwam.
- Het uitschrijven kon ook via de cloud. Deze vond ik pas later. De documentatie zei dat het geluid de machine nooit verliet. Toch stuurde één instelling elk geluidsfragment naar een cloudaanbieder. Een tweede zette de transcriptieserver open voor andere computers in het netwerk, zonder versleuteling. Beide stonden standaard uit. De documentatie noemde ze niet.
Ik heb de documentatie laten aansluiten op de code. Aan de werking veranderden twee dingen. Er staat nergens meer standaard een taalmodel aan, ook niet in de code zelf. En het plafond per klant houdt nu ook het uitschrijven via de cloud tegen.
De wijziging raakte veertien bestanden. Dertien daarvan zijn documentatie. Alles staat publiek op GitHub, de oude tekst ook, in de geschiedenis.
Wat me het meest bezighield: de code was open. Iedereen kon dit nalezen, ik als eerste. Ik deed het pas toen een vragenlijst erom vroeg.
Open source maakt controle mogelijk. Het doet de controle niet voor je.
Ik kende dat patroon al uit ander werk, waar elke poort groen stond terwijl de keten ertussen lekte. Hier groeide de code door en bleef de tekst staan.
Wat privacy by design bij notuleren met AI betekent
Privacy by design staat in artikel 25 van de AVG. Het eerste lid gaat over de opbouw: privacy zit in het ontwerp van het systeem.
Het tweede lid gaat over de startstand. Als niemand iets verandert, wordt alleen verwerkt wat nodig is. Dat deel heet privacy by default.
De Europese privacytoezichthouders hebben uitgeschreven wat dat betekent voor software die je koopt. In hun richtsnoeren over artikel 25 staat het in punt 44.
Wie software van een ander gebruikt, moet die beoordelen. En hij moet ervoor zorgen dat functies zonder rechtsgrond of zonder passend doel uitgeschakeld zijn.
Lees dat nog een keer als je een notetaker aanschaft. De verplichting ligt bij jou, niet bij de maker.
Daarmee wordt de standaardinstelling van je tool jouw zaak. Het hoort in hetzelfde rijtje als de rest van je AI-governance: vastleggen wat je gebruikt, waarvoor en met welke instellingen.
Drie vragen dekken het grootste deel.
Vraag 1: wat staat er standaard aan?
Bij OnCue staat er sinds de versie van begin oktober (1.0.0-rc.2) standaard geen taalmodel aan. De opname wordt lokaal omgezet in tekst. Het geluid zelf wordt niet bewaard, tenzij je dat aanzet.
Er schuift ook geen bot aan in de vergadering. OnCue pakt het geluid van je eigen computer en heeft geen eigen deelnemer in het gesprek nodig.
De herkenning van bezwaren en de coaching op spreektijd draaien ook lokaal, zonder taalmodel. Zonder licentiesleutel maakt de open source versie geen enkele verbinding met mij als maker. Wat een betaalde licentie wel doet, staat in dezelfde privacydocumentatie.
Voor een samenvatting of een verslag kies je zelf een taalmodel. Dat is de volgorde die ik wil: eerst niets en daarna een bewuste keuze.
Bij andere tools kan het andersom liggen. Otter heeft een instelling waarmee de notetaker zelf elke agenda-afspraak met een videolink binnengaat.
Een andere instelling deelt het gesprek met alle gasten op de uitnodiging.
In de Verenigde Staten lopen sinds augustus 2025 class actions tegen Otter over meeluisteren zonder toestemming van alle deelnemers.
Op 13 augustus 2026 liet de rechter de kern van de zaak doorgaan. Of Otter iets fout deed, is daarmee nog niet beslist.
Ook bij Microsoft schuift de standaard. Microsoft kondigde in 2025 aan dat Copilot in Teams-vergaderingen standaard zonder opgeslagen transcript zou werken. In mei 2026 trok het bedrijf dat in.
Een standaard is dus geen vast gegeven. Wat je vorig jaar las, kan vandaag anders zijn.
De vraag aan je leverancier: wat doet de tool als ik hem installeer en niets verander? Gaat hij zelf vergaderingen in, neemt hij op en deelt hij iets?
Vraag 2: welke tekst gaat er per taak naar buiten?
Dit is de vraag die het vaakst vaag wordt beantwoord. "We sturen alleen wat nodig is." Vraag door, per taak.
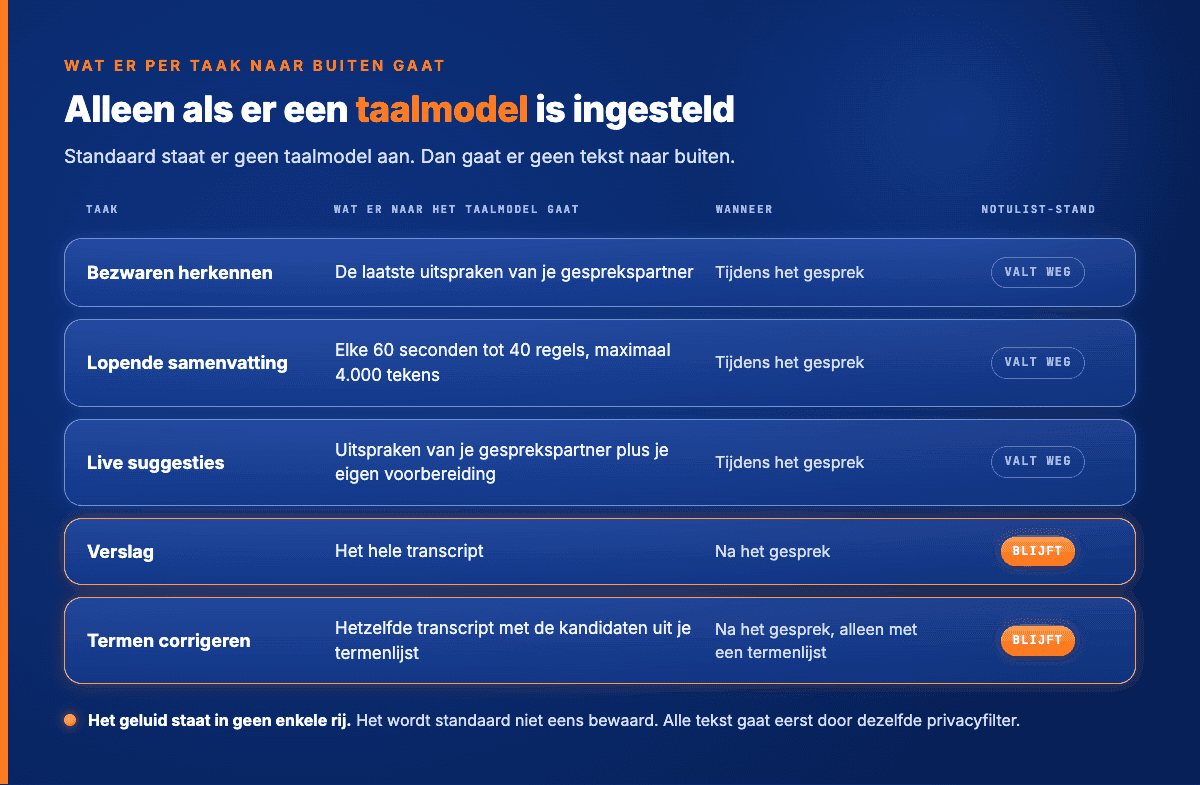
Zo ziet het antwoord er bij OnCue uit, met een taalmodel ingesteld:
| Taak | Wat er naar het taalmodel gaat | Wanneer |
|---|---|---|
| Bezwaren herkennen | De laatste uitspraken van je gesprekspartner | Tijdens het gesprek |
| Lopende samenvatting | Elke 60 seconden tot 40 regels, maximaal 4.000 tekens | Tijdens het gesprek |
| Live suggesties | Uitspraken van je gesprekspartner plus je eigen voorbereiding | Tijdens het gesprek |
| Verslag | Het hele transcript | Na het gesprek |
| Termen corrigeren | Hetzelfde transcript met de kandidaten uit je termenlijst | Na het gesprek, alleen met een termenlijst |
Het geluid staat in geen enkele rij. Standaard wordt het niet eens bewaard. Zet je het uitschrijven zelf op een cloudaanbieder, dan gaat de audio daarheen. Op audio werkt geen filter.
Tel de rijen op en je ziet het verschil met "korte fragmenten". In een gesprek van een uur gaat de samenvatting tot zestig keer naar buiten. Aan het eind gaat het hele gesprek nog een keer.
Als notulist slaat OnCue de eerste drie rijen over. Die draaien binnen de herkenning van bezwaren en die staat in de notulist-stand uit. Er gaat dan alleen na het gesprek tekst naar buiten. Ook dat gebeurt alleen als je een taalmodel hebt ingesteld.
Je kunt per taak een eigen bestemming kiezen. De samenvatting kan naar een lokaal model en het verslag naar je eigen cloudomgeving.
Per klant of per gesprek zet je een plafond voor deze taken. Een taak die daarboven uitkomt, doet geen enkele aanroep. Dat plafond geldt ook voor het uitschrijven. Staat een klant op lokaal, dan weigert OnCue een cloudaanbieder voor de audio al bij de start van het gesprek.
Vraag 3: wat mist de privacyfilter?
Elke notetaker die tekst naar een cloudmodel stuurt, belooft een filter. Vraag hoe hij werkt.
Er zijn grofweg twee soorten. Een filter op patronen, of een model dat namen herkent.
De mijne werkt met patronen. E-mailadressen, Nederlandse telefoonnummers, Nederlandse IBAN's, postcodes en datums hebben een vaste vorm. Die vangt hij.
Namen hebben geen vaste vorm. Daarvoor heeft de filter een lijst van ongeveer 190 Nederlandse voornamen en één patroon: voornaam, tussenvoegsel, achternaam.
Op 3 oktober heb ik vijf zinnen door de echte filter gehaald:
Ik ben Annelies de Groot   ->  Ik ben [NAAM]
Ik ben Annelies            ->  Ik ben Annelies
Ik ben Annelies Jansen     ->  Ik ben Annelies Jansen
Ik ben Jan                 ->  Ik ben [NAAM]
Bakkerij Jansen            ->  Bakkerij Jansen
Annelies staat niet op de lijst. Jan wel. "Annelies de Groot" wordt alleen gevangen door het patroon met een tussenvoegsel. Een achternaam zonder tussenvoegsel of een bedrijfsnaam glipt erdoor.
Een filter met een model is ook geen garantie. Microsoft schrijft over zijn eigen open source filter Presidio letterlijk dat er "no guarantee" is dat hij alle gevoelige informatie vindt.
En een gefilterd transcript is niet anoniem. De Europese toezichthouders zijn daar duidelijk over: gepseudonimiseerde gegevens blijven persoonsgegevens.
Een gefilterd verslag naar een publieke aanbieder blijft dus een verwerking, met een verwerkersovereenkomst erbij. Wat daar verder bij komt kijken, staat in AI en AVG: wat mag wel en wat niet.
Mijn conclusie: kies niet op de filter. Kies op waar de tekst heen gaat. De filter is een vangnet.
Veilig notuleren met AI: vier niveaus
Bij OnCue kies je zelf of en waar een taalmodel meedraait. Er zijn vier niveaus, van zuinig naar ruim.
- Geen taalmodel. De standaard. Transcriptie en live hints draaien lokaal. Er gaat geen tekst naar buiten.
- Een lokaal model. Bijvoorbeeld via Ollama op je eigen machine. Je krijgt een samenvatting en een verslag. De tekst blijft op de machine.
- Je eigen cloudomgeving. Azure OpenAI of Vertex AI, binnen je bestaande contract en regio. Er komt geen nieuwe verwerker bij.
- Een publieke aanbieder met je eigen sleutel. Gemini, OpenAI, Groq of OpenRouter. De filter draait dan standaard en de voorwaarden van die aanbieder gelden.
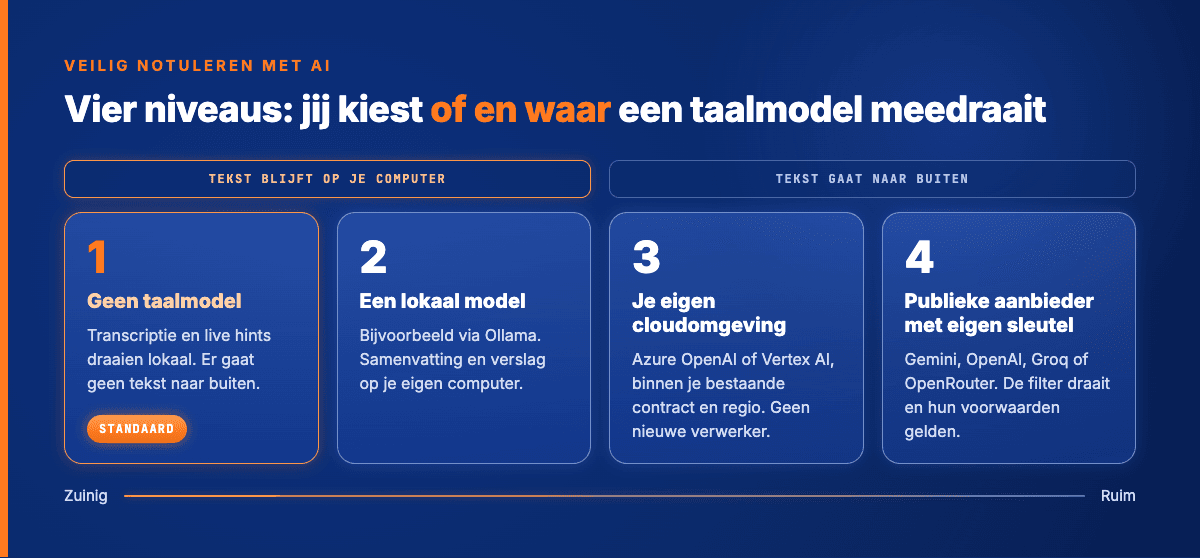
Kies het niveau op de gevoeligheid van het gesprek, niet op hoe goed je de filter vertrouwt. Een sollicitatiegesprek hoort op niveau 1 of 2. Een openbaar webinar mag op niveau 4.
Lokaal is niet vanzelf veilig. Het risico verhuist naar je eigen machine: wie erbij kan, wat er in de back-up staat en of je klantmap naar iCloud synchroniseert. OnCue waarschuwt voor dat laatste.
Veelgestelde vragen
Wat je nu kunt doen
Pak de notetaker die je nu gebruikt en stel hem de drie vragen. Wat staat er aan als ik niets verander? Welke tekst gaat er per taak naar buiten? Hoe herkent de filter een naam?
Geeft je leverancier op de tweede vraag geen antwoord per taak? Dan weet je genoeg.
Wil je zien hoe zo'n antwoord eruitziet als je het opschrijft? De privacydocumentatie van OnCue staat op GitHub. Daar staat per taak wat er naar buiten gaat en waar de filter ophoudt. Inclusief wat ik eerst verkeerd had. Wil je het zelf proberen? OnCue heeft een notulist-stand die alleen uitschrijft, zonder coaching. De stappen staan bovenaan de README, ook in het Nederlands.
Meer over de tool zelf staat op de OnCue-pagina.