Op 7 oktober stuurde ik mijn AI vanaf mijn telefoon drie korte berichten. Daarna gaf ik hem vijf dagen lang geen opdracht, geen besluit en geen correctie.
In die tijd werden 106 wijzigingen samengevoegd in de code van een SaaS-product dat ik bouw. Ik vroeg dertien keer om status.
Human in the loop, heet dat. Achteraf bleken die vragen om status meer te doen dan ik dacht.
Vijf dagen, dertien keer "status?"
Het product is nog in ontwikkeling en nog niet in productie. Het plan voor het werk lag al klaar, opgeknipt in golven.
Mijn drie berichten waren kort. Open de vorige sessie. We waren met golf 5 en 6 bezig. En op welk account hij moest starten.
Op de klok liep het daarna 5,4 dagen. Ruim 54 uur daarvan was de AI echt bezig. Hij zette ruim 4.200 stappen.
Hij werd 344 keer gewekt door een melding dat werk op de achtergrond klaar was. Dan pakte hij de volgende stap op.
Er stond geen automatische lus aan die hem liet doorgaan.
De rest van de tijd deed hij zelf niets. Soms wachtte hij op werk op de achtergrond. Soms stond hij echt stil.
Op 9 oktober liep hij twee keer tegen een limiet van mijn account aan. Na de tweede keer bleef hij ook na de reset nog zo'n zeventien uur stil.
Van 10 op 12 oktober stond hij 29,6 uur stil. De controles op zijn werk draaiden in een apart venster. Als die klaar zijn, krijgt hij geen melding.
Hij wachtte dus op een seintje dat nooit kwam. Op 11 oktober is er niets samengevoegd.
Na elk van die stiltes begon hij pas weer toen ik om status vroeg.
Tien van mijn dertien vragen gingen over de stand. Drie keer vroeg ik of ik zelf iets moest doen.
De reeks eindigde op 12 oktober met een besluit van mij dat al sinds 7 oktober openstond: maak het volgende onderdeel af.
Wat er vastlag
Vier dingen lagen vast voordat het begon.
- Een plan vooraf. Het werk was opgeknipt in golven en kleine wijzigingen. "We waren met golf 5 en 6 bezig" was genoeg om verder te gaan.
- Werk verdelen. De AI zet taken uit bij AI-werkers. Die werken elk in een eigen map, los van de AI die alles aanstuurt.
- Een poort per wijziging. Bij elke wijziging keurde één AI-reviewer van een andere aanbieder goed. Ook draaide de volledige testset op precies die versie.
- Eerst de stand lezen. Bij elke start leest de AI eerst de overdracht van de vorige sessie.
Alle 106 wijzigingen gingen door die poort.
Pas als review en testpoort allebei groen stonden, werd een wijziging samengevoegd. Er stond bewust geen mens in die stap.
Mijn open-source framework heeft dezelfde vier dingen. Toch liep het daar anders.
Waarom mijn framework niet zo lang doorliep
In dezelfde week stuurde ik de AI van mijn framework 60 berichten. Daar werden 14 wijzigingen samengevoegd.
De langste periode zonder sturing duurde 3,7 uur werk.
Over de hele maand vroeg die AI vaker om een besluit. Bij mijn framework was dat 38 procent van zijn stops, bij het SaaS-product 19 procent.
Mijn verklaring: bij het SaaS-product lag het plan vast. Bij het framework ging het die week om ontwerpkeuzes. Die legt de AI aan mij voor.
Bewezen is dat niet. Ook bij het SaaS-product lagen besluiten open. De AI parkeerde ze en werkte door aan wat klaarlag.
Anthropic zag iets vergelijkbaars bij het gebruik van hun eigen codeer-agent.
Op de meest complexe taken stopt die agent meer dan twee keer zo vaak om iets te vragen als de mens hem onderbreekt.
Mijn les: hoe meer er vooraf in het plan vastligt, hoe minder de AI in de chat hoeft te vragen.
Human in the loop: wat ik een maand lang deed
Ik liet een AI de transcripten van een maand doorrekenen, van 14 september tot en met 14 oktober. Hij telde alleen wat ik zelf typte.
Ik stuurde 1.371 berichten aan de twee AI's. Zij zetten samen ruim 26.000 stappen en voegden 478 wijzigingen samen.
Een AI beoordeelde daarnaast een blinde steekproef van 240 berichten, los van de telregels. Daaruit komt de verdeling hieronder.
Ongeveer 60 procent van mijn berichten stuurde. De rest was meekijken. Ik speelde vier rollen:
- Opdrachtgever, ruim een kwart: een nieuwe opdracht of richting.
- Beslisser, een op de acht: een keuze die de AI voorlegde.
- Uitvoerder, ongeveer een op de acht: iets wat de AI niet kon of niet mocht.
- Meekijker, ongeveer 40 procent: een vraag om status of een "ga door".
Ongeveer een op de zeventien berichten was een correctie.
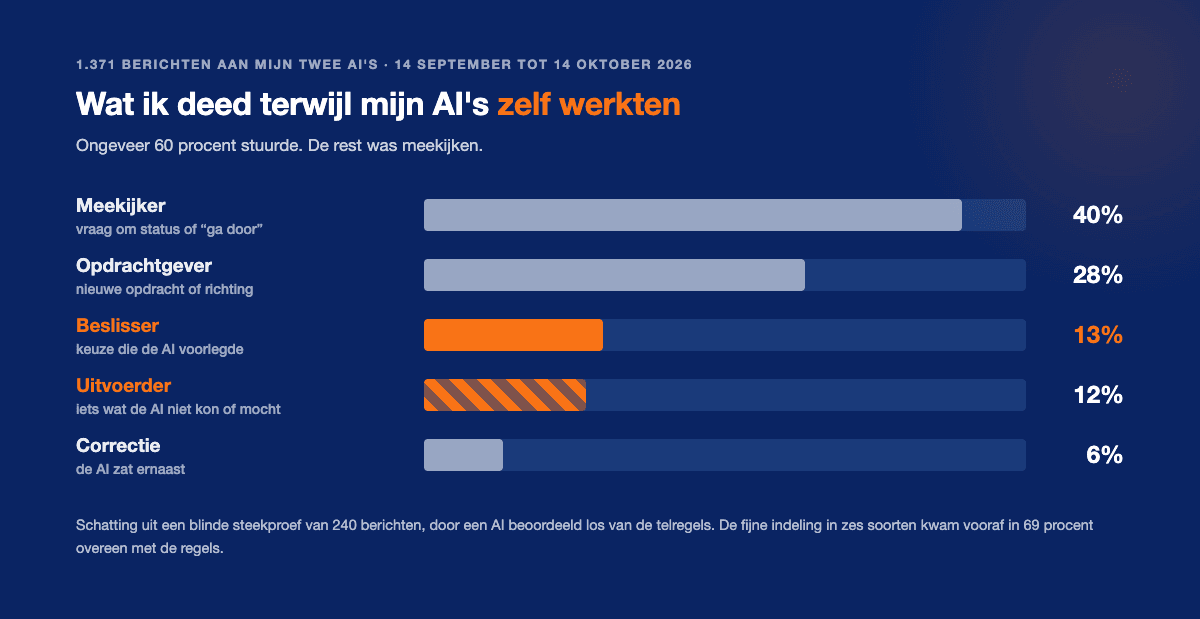
De verdeling is een schatting. Over de fijne indeling in zes soorten waren regels en steekproef het vooraf in 69 procent eens.
Over de grove vraag of een bericht stuurt, was dat 92 procent. Die regels waren wel op dezelfde steekproef bijgesteld.
Het meekijken had bovendien een functie die ik niet zag. Bij het SaaS-product was mijn vraag om status de wekker.
Waar de mens nog nodig was
Op 14 oktober moest bij mijn framework nieuw werk worden vrijgegeven. Die stap mag alleen ik zetten.
Het veiligheidsfilter van mijn AI-tool liet de AI dat ook na mijn akkoord in de chat niet doen.
Ik typte het commando zelf. Mijn eerste poging werd niet uitgevoerd. Pas het commando met de juiste map werkte. Achttien minuten voor één regel tekst.
Die poort wil ik houden. Een ander soort werk niet.
Bij het SaaS-product deed ik die maand zo'n zestig keer een stap die de AI niet kon of mocht zetten. Vijftig keer was mijn antwoord "done" of de uitvoer.
Meestal plakte ik commando's op een server of in een database. Daar viel niets te beoordelen. Ik was de handen van de AI, niet zijn toezicht.
De ethische richtsnoeren van de EU kennen die rol niet. Daar is de mens degene die toezicht houdt en kan ingrijpen.
Volgens die richtsnoeren is een mens bij elke beslissing "in veel gevallen mogelijk noch wenselijk".
Wie minder toezicht houdt, moet meer testen en strenger controleren. Die ruil maakte ik.
📖 Lees ook: Waarom 'autonome' AI-agents niet bestaan: de vier fasen naar AI die zelfstandig werkt en waarom je er geen overslaat
478 keer mijn naam
GitHub zet alle 478 samengevoegde wijzigingen op mijn account. De commando's om samen te voegen gaf de AI zelf. Dat staat in de transcripten.
Wie later het spoor leest, ziet alleen mijn naam. Dat een AI de knop indrukte, staat er niet bij.
Voor een bedrijf is dat het belangrijkste punt. Een AI-agent die onder jouw naam handelt, is niet hetzelfde als jouw akkoord.
Wat dat betekent als er schade ontstaat, werkte ik uit in aansprakelijkheid bij AI.
Waar human in the loop een stempel wordt
Ongeveer 6 procent van mijn berichten was een correctie. Dat kan betekenen dat de AI goed werkt. Het kan ook betekenen dat ik niet kritisch genoeg keek.
Mijn meting kan die twee niet uit elkaar halen. Ze telt geen fouten die ik heb gemist.
Het raamwerk voor AI-agents van Singapore noemt een laag aantal afwijzingen een mogelijk teken van afstempelen.
Anthropic meet dat gebruikers 93 procent van de toestemmingsvragen goedkeuren.
Dat leidt volgens Anthropic tot goedkeuringsmoeheid. Mensen letten dan niet meer goed op wat ze goedkeuren.
Waar je het tweede paar ogen dan wel zet, beschrijf ik in het vier ogen principe bij AI.
Wat de AI Act vraagt
Artikel 14 van de AI Act eist menselijk toezicht op AI-systemen met een hoog risico. De mens moet de uitkomst kunnen negeren en het systeem kunnen stoppen.
Door de Digital Omnibus gelden die eisen pas vanaf 2 december 2027. Voor producten onder Europese productwetgeving is dat 2 augustus 2028.
Een AI-agent die je eigen software schrijft, is geen systeem met een hoog risico. Artikel 14 geldt daar niet.
Je moet wel maatregelen nemen om de AI-geletterdheid van je mensen te ondersteunen. Meer daarover op mijn pagina over de AI Act.
Wat ik je zou aanraden
- Leg het plan vooraf vast. Wat vaststaat kan de AI afwerken. Ontwerpkeuzes leg je bewust bij een mens.
- Zet een poort op elke wijziging in plaats van een mens op elke stap.
- Zorg dat de AI weer wakker wordt. Een controle die klaar is, moet hem een seintje geven. Anders is jouw vraag om status de wekker.
- Leg vast wie wat deed. Een akkoord van een AI-reviewer is iets anders dan het jouwe.
Wat deze meting niet laat zien
- Eén persoon, twee projecten. Mijn werk, mijn systeem en alleen software. Voor klantcontact of de boekhouding zegt dit weinig.
- Geen gemiste fouten. De meting telt wat ik corrigeerde, niet wat ik over het hoofd zag.
- Wat er verloren ging. In die vijf dagen werd het werkgeheugen van de AI dertien keer automatisch ingekort. Wat daarbij wegviel, is niet gemeten.
- Eén reviewer per wijziging. Bij het SaaS-product keurt per wijziging één AI-reviewer. Een tweede, onafhankelijke review is daar niet ingericht.
- Meekijken is ook kijken. Dertien keer vroeg ik om status. Niet sturen is iets anders dan niet kijken.
Veelgestelde vragen
Waar je begint
Hoe ver een AI-agent in jouw bedrijf zelf kan doorwerken, hangt af van het plan en de poorten. Hoe ik dat met je uitzoek, lees je op mijn pagina als AI-consultant.