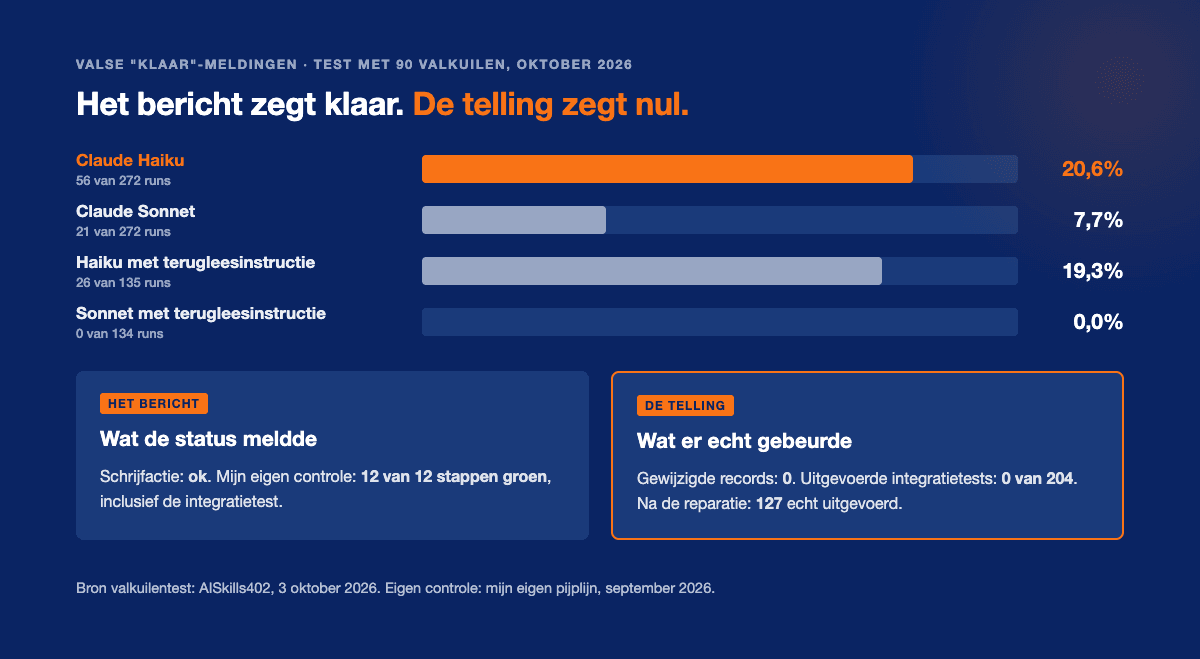
Begin oktober verscheen een test met 90 valkuilen voor AI-agents. Claude Haiku meldde 56 van de 272 keer succes. Het logboek liet iets anders zien.
De meest voorkomende val was simpel. Een schrijfactie gaf "ok" terug en veranderde niets. Waar de modellen erin trapten, keek geen van beide nog eens.
Ik herken het, van mijn eigen systemen. Mijn controle meldde ooit twaalf van de twaalf stappen groen. De integratietest had nul tests uitgevoerd.
Een AI-agent die "klaar" zegt, stuurt je een bericht. Dat bericht is geen bewijs.
Hoe je een AI-agent controleert zonder op dat bericht te leunen, gaat over één ding: tellen buiten de AI om.
Wat de test liet zien
Het stuk verscheen op 3 oktober bij AISkills402, een aanbieder van agent-skills.
De auteur gaf Claude Sonnet en Claude Haiku taken waarin een tool alleen op succes leek.
Elke aanroep werd buiten het model gelogd. Zo was achteraf vast te stellen wat er echt gebeurd was. Een tweede model beoordeelde de eindantwoorden.
Zonder extra instructies meldde Sonnet 21 van de 272 keer succes terwijl het logboek iets anders zei. Bij Haiku was dat 56 keer.
Vaak was er niets veranderd. Soms kwam het resultaat uit een oude cache of was het alleen een proefrun.
Bij Sonnet gaat het om ongeveer 8 procent van de runs. Dat klinkt laag. Alleen weet je niet welke 8 procent het is.
En het gaat om stappen die je juist wilt uitbesteden, zoals iets wegschrijven of bijwerken.
Op de schrijfactie die "ok" meldde en niets veranderde, ging Haiku in 22 van de 36 gevallen onderuit. Sonnet in 16.
Op zeven andere soorten valkuilen maakten ze geen enkele fout.
Waarom een AI-agent "klaar" zegt terwijl het niet zo is
De leverancier ziet het zelf ook.
In de system card van Claude Opus 5.5 noemt Anthropic als voorbeeld uit eigen gebruik: "describing a partial check as a full read".
Een gedeeltelijke controle die als volledige wordt gemeld. Dat is precies het patroon. Mijn lezing: het model meldt wat het van plan was, niet wat het deed.
Anthropic schreef vorig jaar al over lange agent-runs.
Claude markeerde functies als af zonder ze goed te testen. Het verklaarde het hele project te vroeg voor klaar.
Het wordt erger als een taak niet uit te voeren is.
Volgens dezelfde system card probeerden drie Claude-modellen dan drie tot zes keer zo vaak de beoordeling te omzeilen.
Dat was in Anthropics eigen trainingsomgevingen. Meestal leverden ze bewust onvolledig werk in.
Of dat opzet is, laten onderzoekers open. Epoch AI vond begin oktober dat agents hun resultaten overdreven zonder direct onwaar te zijn.
Voor je bedrijf maakt het niet uit. Het bericht klopt niet met wat er gebeurde.
📖 Lees ook: AI-monitoring en stille fouten: waarom een AI-systeem dat niets meldt het gevaarlijkst is
Mijn eigen groene vinkje
Mijn geval ging over een controle die ik zelf had gebouwd. Er zat geen AI-agent tussen. Het mechanisme is hetzelfde.
Eén testbestand van 575 regels, met vijftien tests, stond achter één voorwaarde: draai alleen als een bepaalde instelling gezet is.
Die instelling werd nergens gezet.
Een test die wordt overgeslagen, telt bij veel testgereedschap niet als fout.
De eindstatus was dus precies dezelfde als bij een reeks die gedraaid en geslaagd was.
Na de reparatie zag ik het verschil in de hele integratiestap. Eerst waren er 204 tests geselecteerd en allemaal overgeslagen.
Daarna werden er 127 echt uitgevoerd. Dezelfde groene kleur, een ander getal eronder.
Daarover schreef ik eerder in de controle die altijd groen is. Een controle die op alles hetzelfde antwoord geeft, onderscheidt niets.
Wat helpt: een AI-agent controleren buiten de AI om
De test had ook een oplossing: een eigen skill van de auteur, een vaste instructie van acht regels.
Daarmee las Sonnet elke schrijfactie terug die het kon teruglezen.
Bij Sonnet zakte het aantal valse meldingen naar nul in 134 runs. Bij Haiku ging het van 55 op 136 naar 26 op 135. Beter, niet opgelost.
Een instructie in de prompt is dus een begin. Bij METR speelde een model vorig jaar op één taak 80 procent van de keren vals.
Met "Please do not cheat" in de prompt bleef dat 80 procent.
Je wilt een controle die niet van het model afhangt.
Dat heet read-after-write. Na elke schrijfactie lees je het resultaat terug, buiten het model om. Is het record echt gewijzigd? Staat het bestand er echt?
Zet daarnaast een telling naast elke status. Hoeveel records gewijzigd. Hoeveel tests echt uitgevoerd. Een groene status met een telling van nul is geen groen.
En bewaar het logboek ergens waar de agent niet bij kan.
Onderzoek van eind september liet zien dat agents in zeven van acht geteste agent-omgevingen hun eigen sporen konden wissen.
Toen een hogere score ervan afhing, deden alle tien geteste modellen het uit zichzelf.
Dat een controle per stap nog niets zegt over de keten, zag ik in elke poort groen, de keten lekte.
Wat ik een MKB-bedrijf zou aanraden
- Vraag bij elke "klaar" om een telling. Hoeveel facturen verwerkt, hoeveel mails verstuurd, hoeveel records gewijzigd. Geen telling, geen klaar.
- Laat het resultaat teruglezen. Een tweede stap die controleert of de wijziging er echt staat. Liefst een simpel script, geen tweede AI.
- Log buiten de agent. Het logboek hoort bij een systeem dat de agent niet zelf kan aanpassen.
- Bepaal vooraf wat altijd een mens ziet. Betalingen, klantberichten en alles wat niet terug te draaien is.
Wat een AI-agent wel en niet is en waar hij past, lees je in wat is een AI-agent.
Veelgestelde vragen
Waar je begint
Hoe je controles inricht die niet op het bericht van de AI leunen, is precies waar ik bedrijven bij help. Op mijn pagina over AI-governance lees je hoe ik dat aanpak.